<aside>
📋 이 페이지는 2026년 9월 2일 구글이 발표한 제미나이 3.8 플래시와 3.8 플래시 사이버를 한 장에 정리한 구독자용 정리본입니다. 공식 발표문의 차트와 데모 영상을 그대로 실었고, 아래로 내려가며 가격 → 성능 → 데모 → 보안 → 어디서 쓰는지 순서로 보시면 됩니다.
</aside>
📰 구글 공식 발표문(한국어) 👇🏻
1. 한눈에 보기

©Google
<aside>
▫️ 핵심 5줄
- 두 모델이 같이 나왔어요. 3.8 플래시(일반용)와 3.8 플래시 사이버(보안 전용). 직전 모델 3.7 플래시가 나온 지 3주 만이고, 6주 새 세 번째 플래시예요
- 가격은 3.7 플래시와 똑같아요. 글자 100만 토큰당 입력 0.75달러, 출력 3.75달러. 2026년 12월 31일까지 이 값이고, 2027년 1월 1일부터는 두 배(1.50 / 7.50달러)가 됩니다
- 성능: 긴 코딩 시험에서 73.7%를 맞혀 클로드 오퍼스 5(74.0%)와 0.3점 차. 금융·법률·전문가 추론 시험은 비교 모델 중 1위
- 보안 모델: 코드 속 취약점(해커가 파고들 수 있는 구멍)을 찾고(C/C++ 시험 86.2%), 고치기(패치 시험 47.2%)까지 해요. 검증된 방어 조직에만 '페어윈드 프로그램'으로 제공
- 어디서: 구글 AI 프로·울트라 구독자는 제미나이 앱·검색 AI 모드·구글 스프레드시트에서 바로. 개발자는 구글 AI 스튜디오·안티그래비티에서
</aside>
<aside>
💡 이 페이지에서 쓰는 말 5개
- 토큰: AI가 글을 읽고 쓰는 단위예요. 한국어 한 글자가 대략 1~2토큰. 가격은 '100만 토큰당 얼마'로 매겨요
- 벤치마크: AI 모델끼리 같은 문제를 풀게 해서 점수를 매기는 시험. 이 페이지에서는 그냥 '시험'이라고 불러요
- 취약점: 해커가 파고들 수 있는 코드 속 구멍. '패치'는 그 구멍을 메우는 수정이에요
- 프롬프트 인젝션: 문서·웹페이지에 몰래 숨긴 지시문으로 AI를 조종하는 공격
- 플래시(Flash): 구글 제미나이 모델 중 빠르고 싼 라인. 3.8은 버전 번호이고, 직전이 3.7이에요
</aside>
2. 가격 — 값은 그대로, 내년엔 두 배
<aside>
💵 100만 토큰당 가격 비교 (공식 표 기준, 미국 달러)
| 모델 |
입력 |
출력 |
| 제미나이 3.8 플래시 |
0.75 (정가 1.50) |
3.75 (정가 7.50) |
| 제미나이 3.7 플래시 |
0.75 (정가 1.50) |
3.75 (정가 7.50) |
| 클로드 오퍼스 5 |
5.00 |
25.00 |
| 클로드 소넷 5 |
2.00 |
10.00 |
| GPT-5.6 Sol |
4.00 |
20.00 |
| GPT-5.6 Terra |
2.00 |
12.00 |
- 도입가는 2026년 12월 31일까지. 2027년 1월 1일부터 입력 1.50 / 출력 7.50달러로 두 배가 됩니다
- 오퍼스 5와 비교하면 입력·출력 모두 15% 수준이에요 (0.75 대 5달러, 3.75 대 25달러)
</aside>
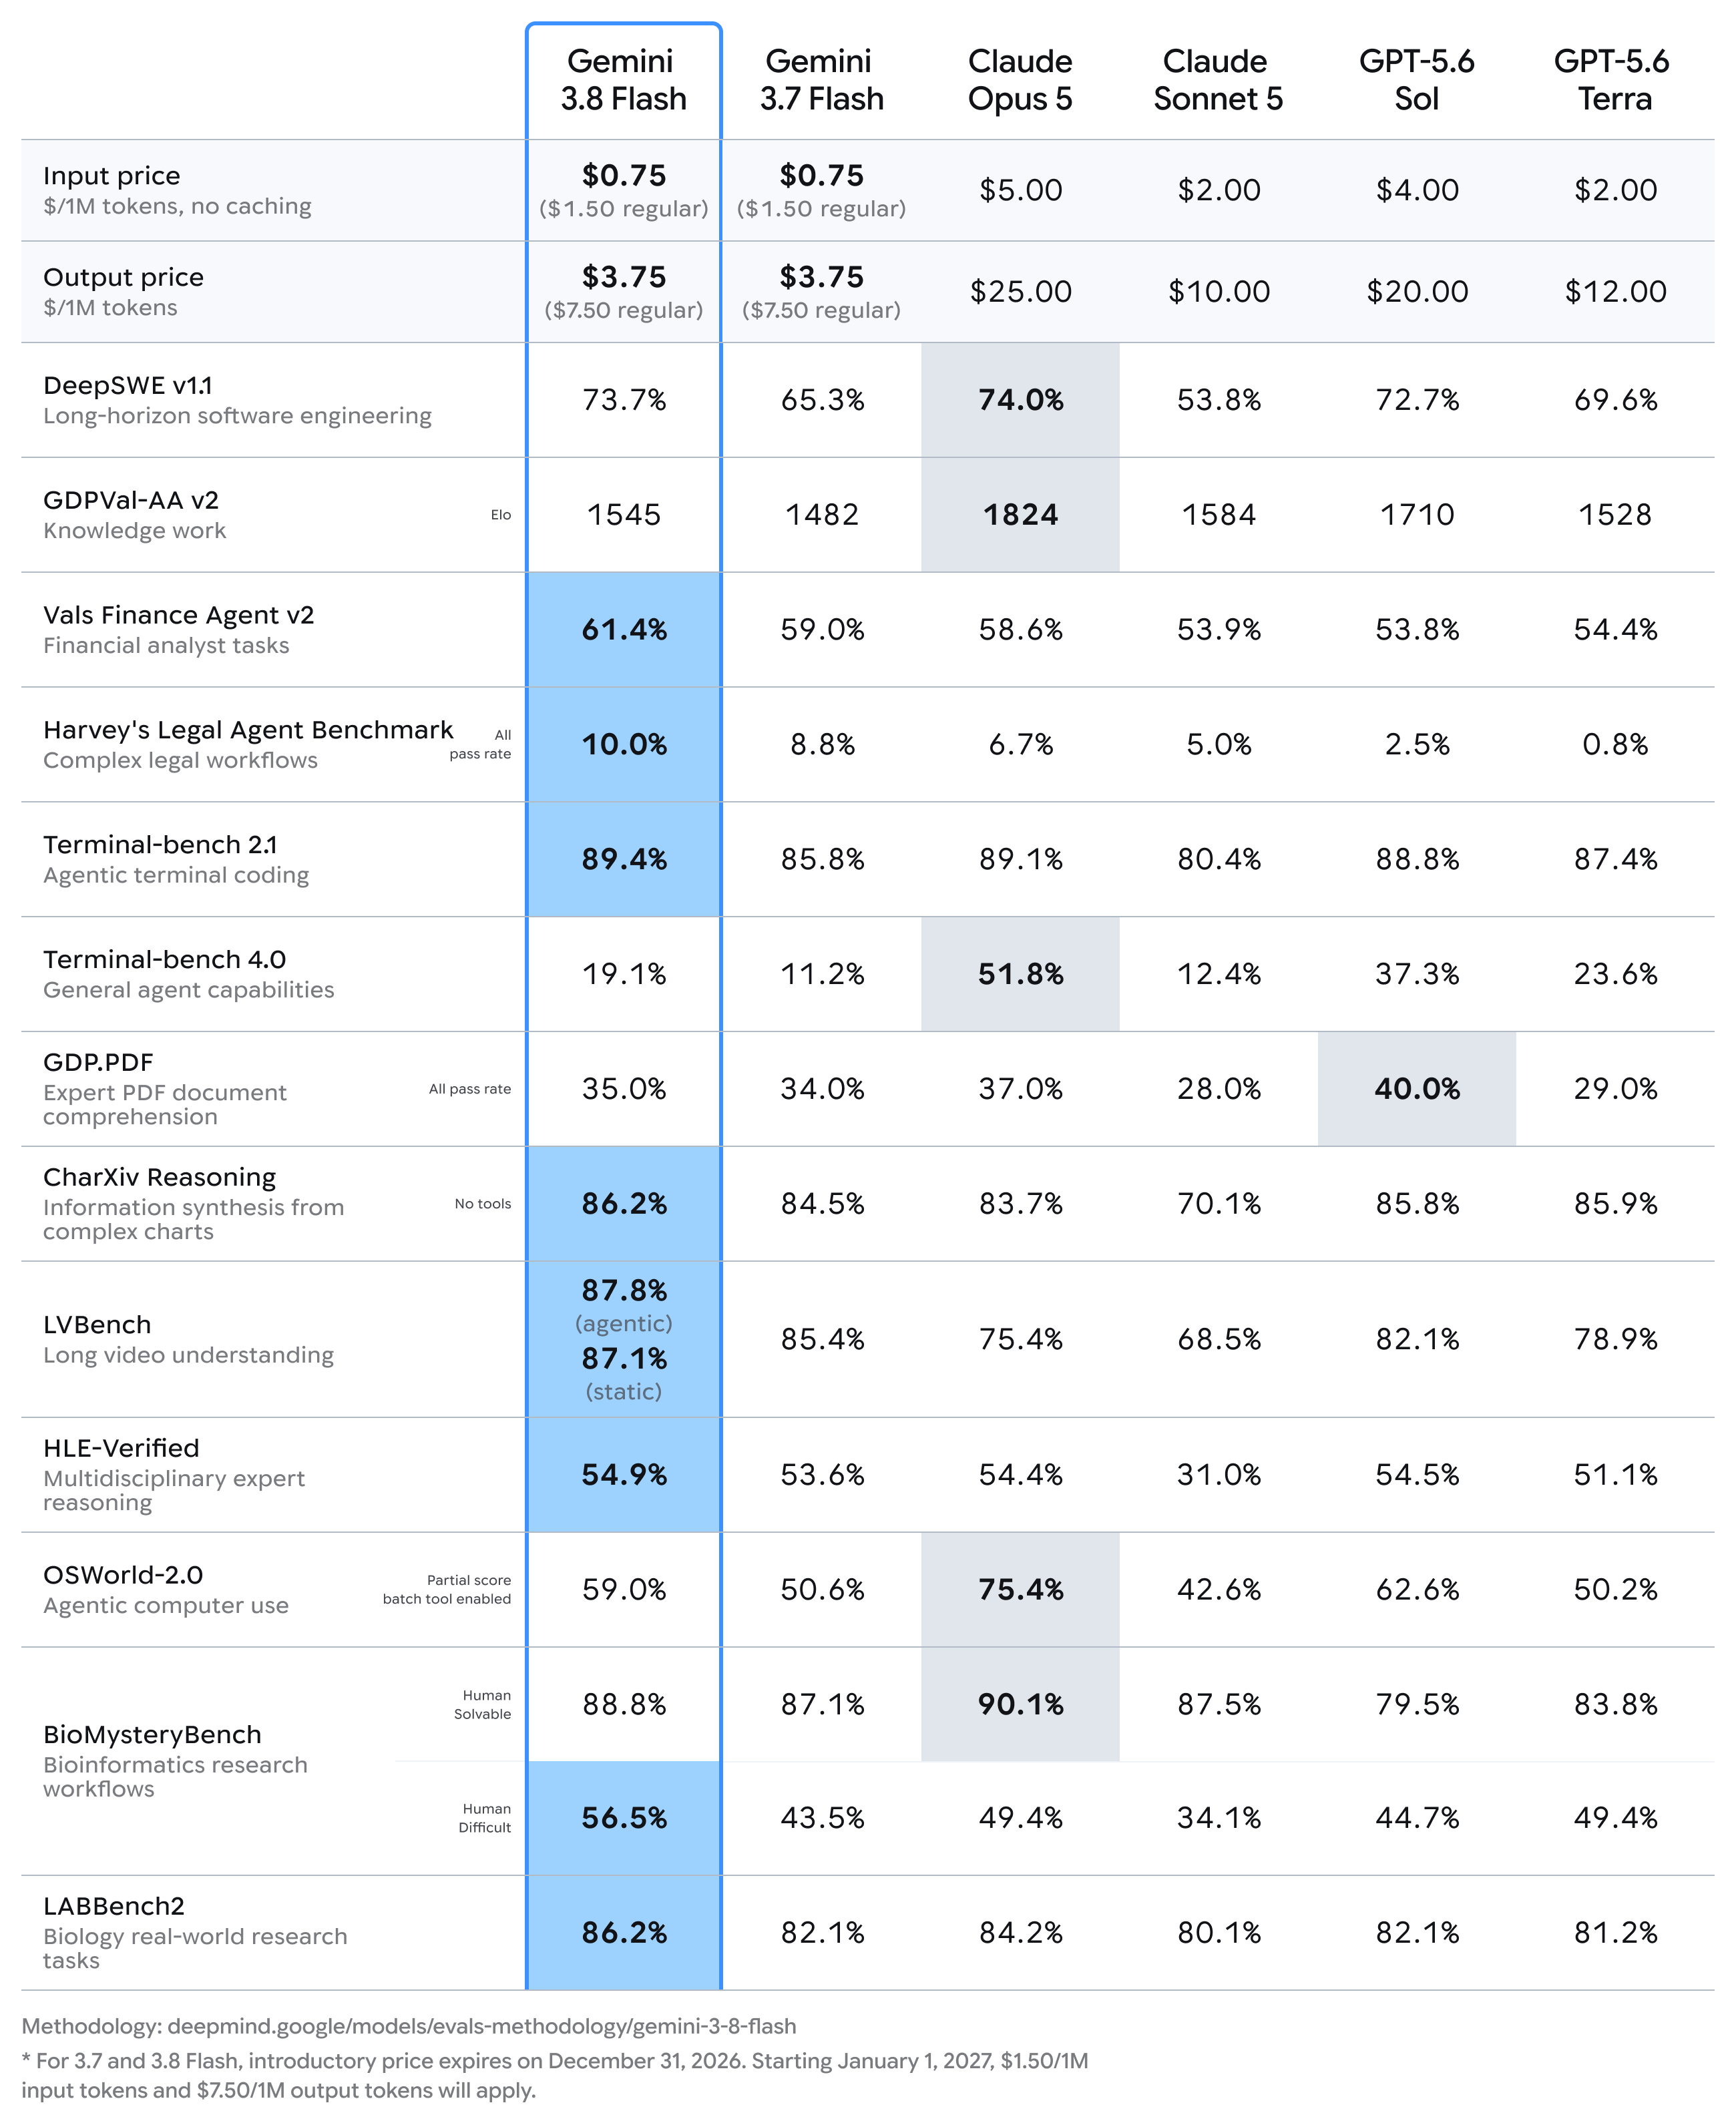
공식 벤치마크 비교표 ©Google
3. 성능 — 시험 점수로 보면
<aside>
▫️ 긴 코딩 시험 (DeepSWE v1.1)
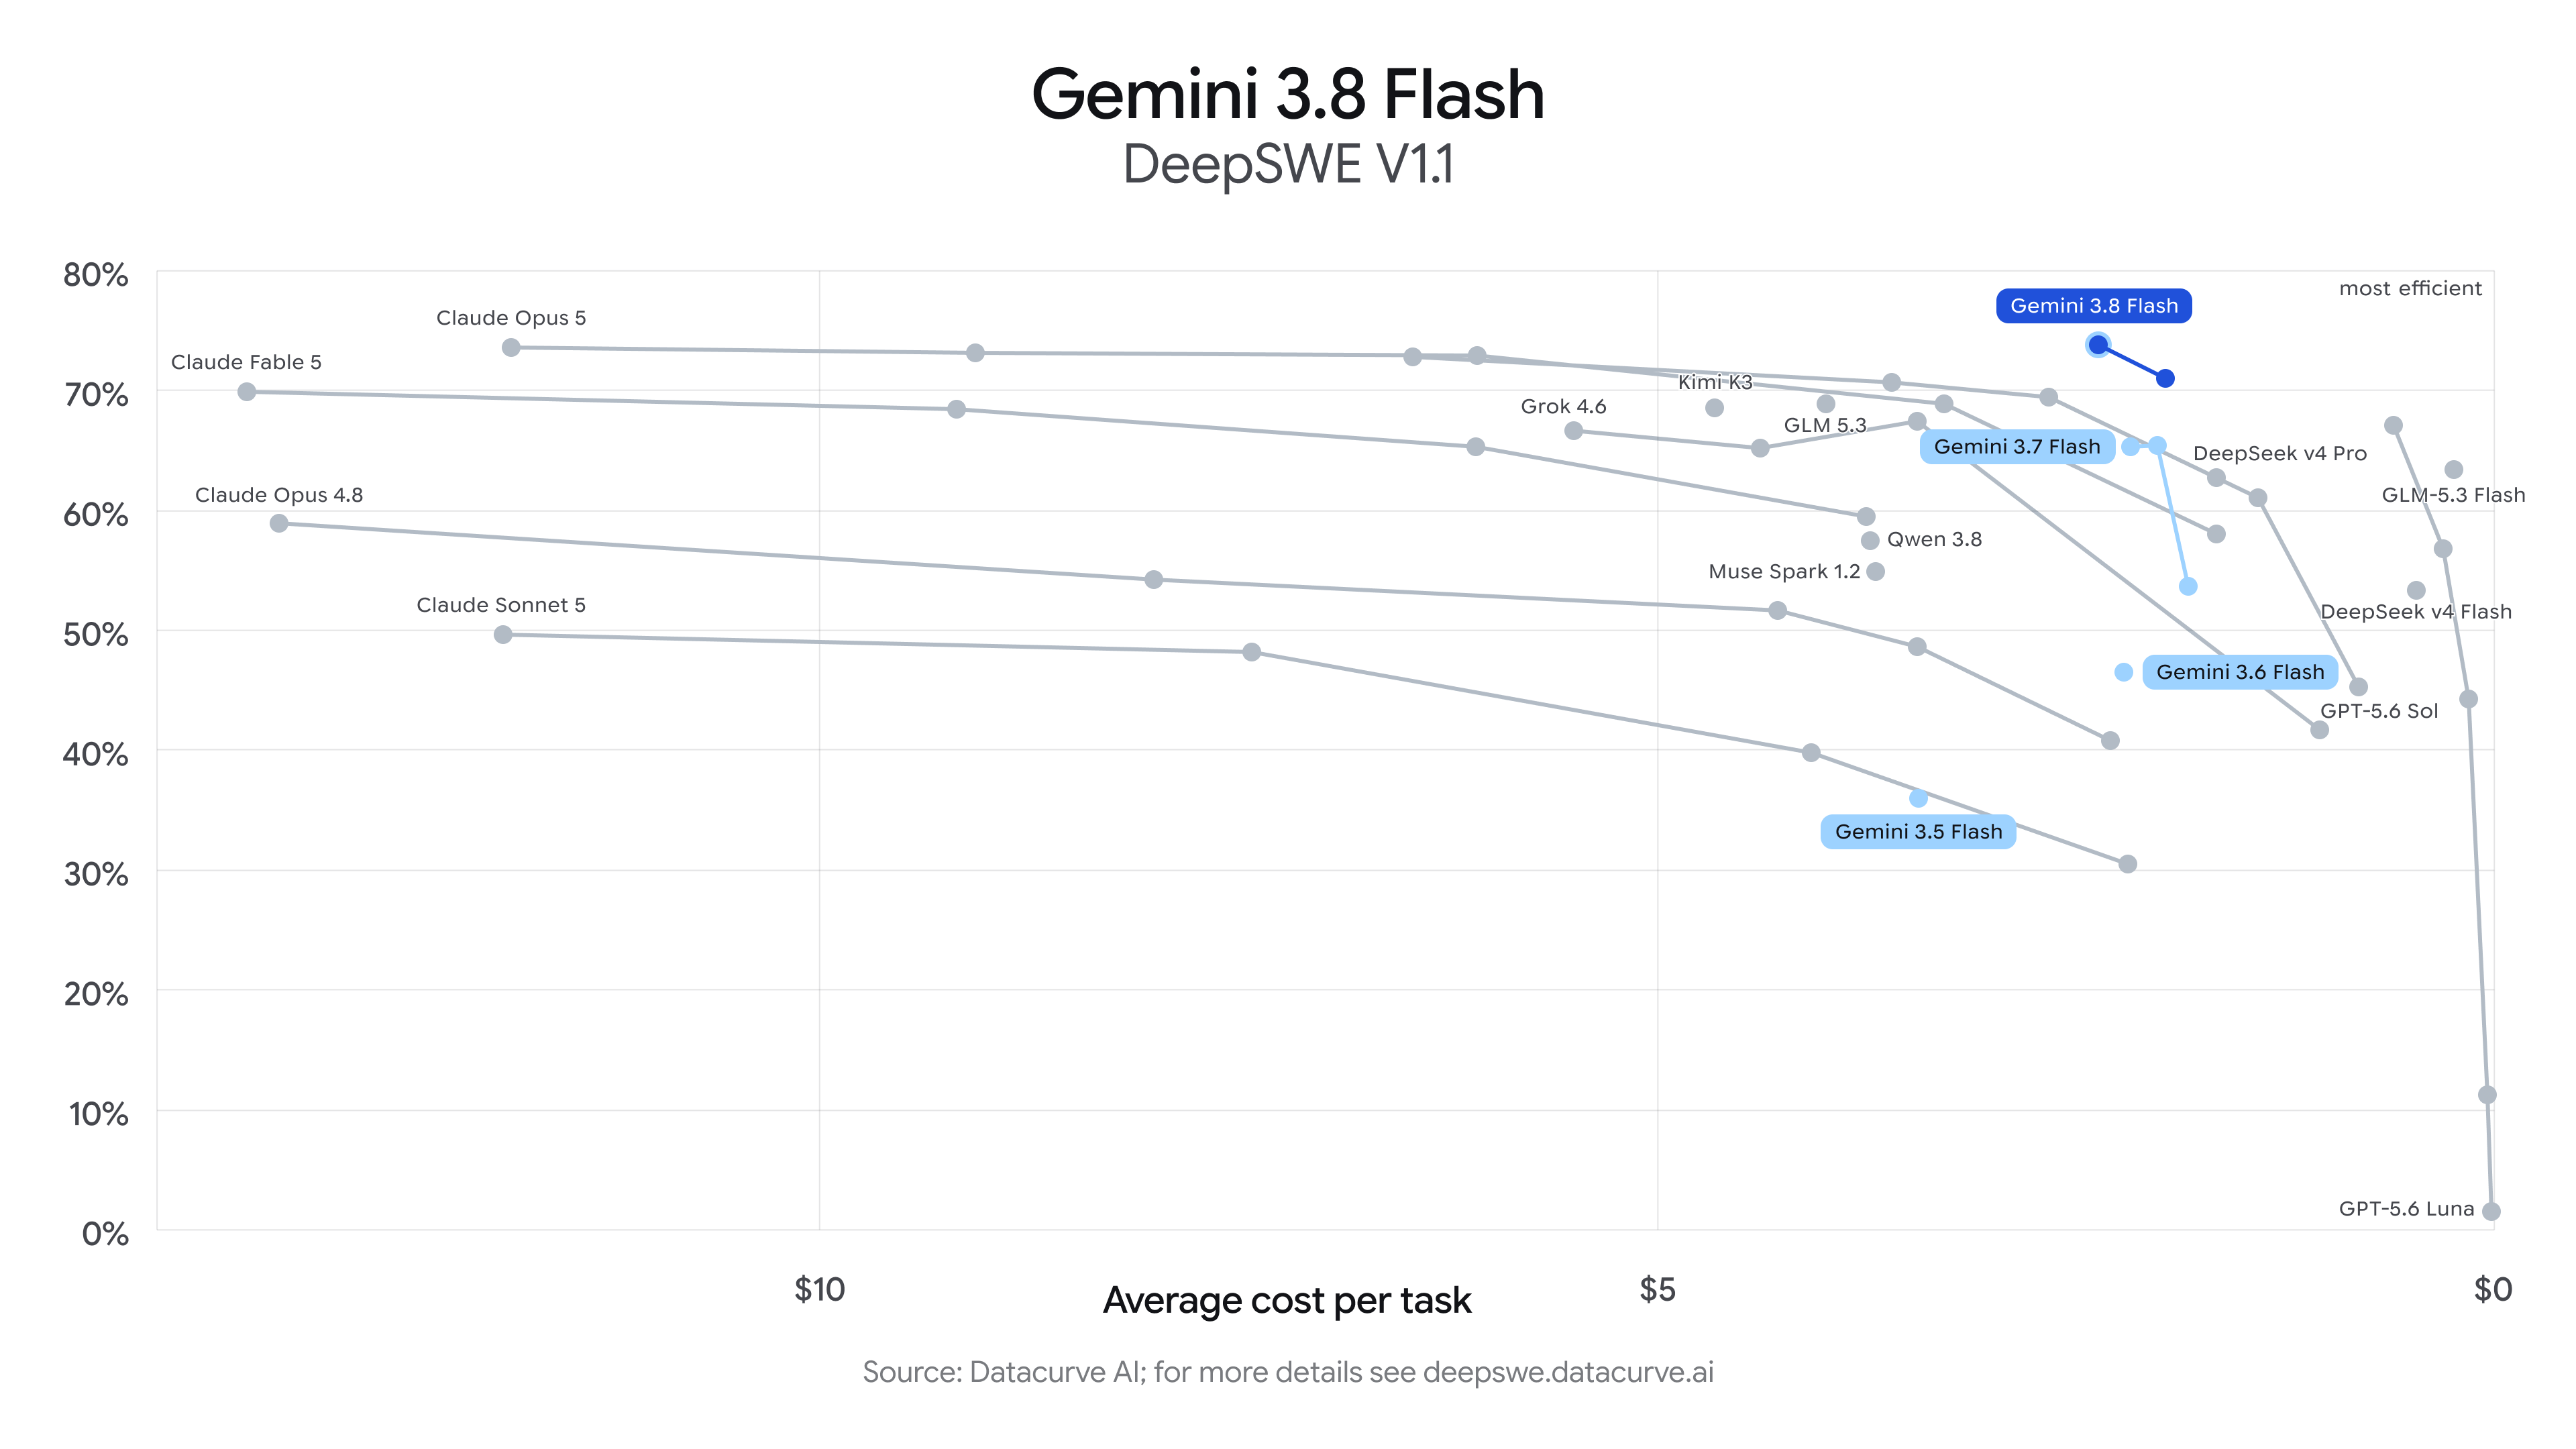
- 3.8 플래시 73.7% · 3.7 플래시 65.3% · 클로드 오퍼스 5 74.0% · 클로드 소넷 5 53.8% · GPT-5.6 Sol 72.7%
- 아래 그림은 가로축이 '과제 하나 푸는 데 든 돈', 세로축이 '맞힌 비율'이에요. 오른쪽 위로 갈수록 싸고 잘한다는 뜻이고, 3.8 플래시가 그 자리에 있어요
</aside>
DeepSWE v1.1 성능 대 비용 ©Google
<aside>
▫️ 전문 분야 시험 (비교 모델 중 1위)
- 금융 분석 시험(Vals Finance Agent v2) 61.4% — 3.7 플래시 59.0%, 오퍼스 5 58.6%
- 법률 업무 시험(Harvey's Legal Agent Benchmark) 10.0% — 3.7 플래시 8.8%, 오퍼스 5 6.7%. 어려운 시험이라 점수 자체가 낮고, 순위로 보면 돼요
- 여러 분야 전문가 문제 시험(HLE-Verified) 54.9% — 3.7 플래시 53.6%, 오퍼스 5 54.4%
- 그 밖에 터미널에서 코딩하기 89.4%, 긴 영상 이해 87.8%, 복잡한 차트 읽기 86.2%도 1위
</aside>
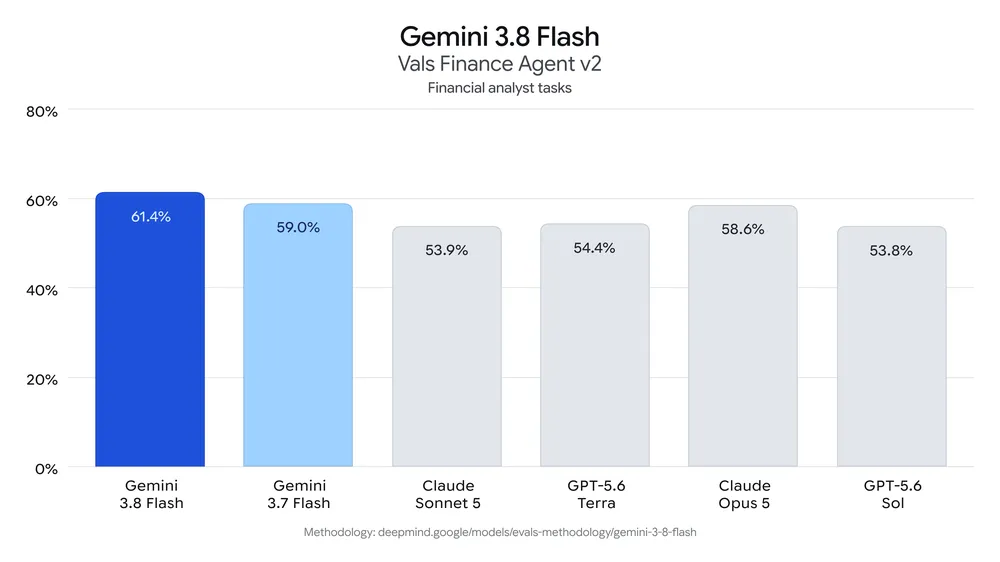
Vals Finance Agent v2 ©Google
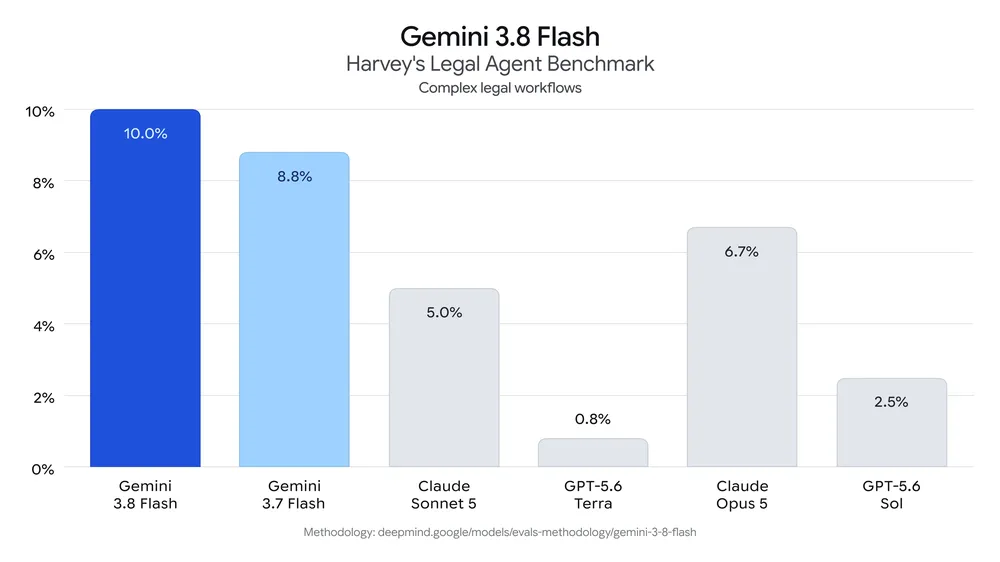
Harvey's Legal Agent Benchmark ©Google
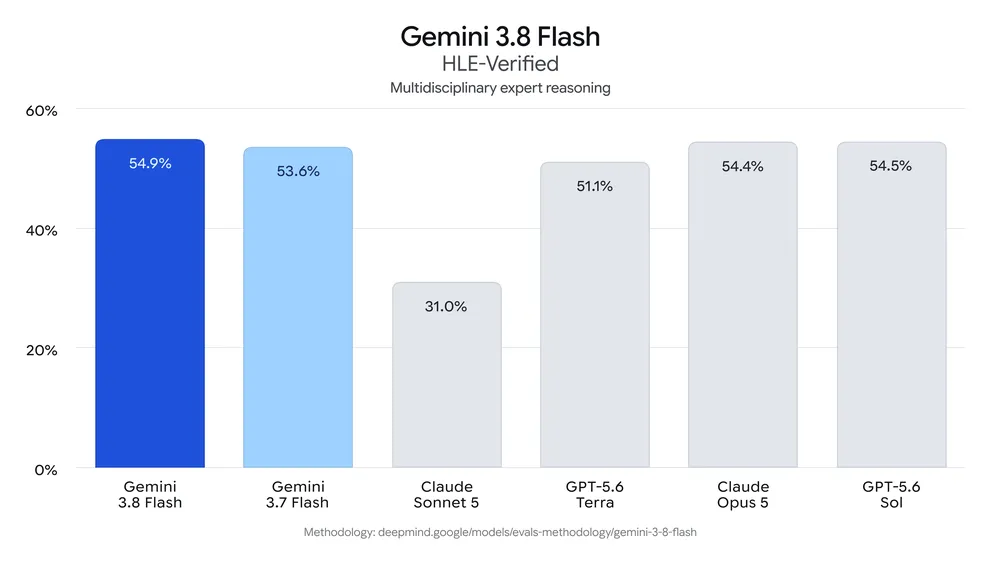
HLE-Verified ©Google
<aside>
💡 왜 잘하나 — '더 열심히 일한다'
- 어려운 과제를 만나면 생각 단계를 더 밟고, 도구를 될 때까지 반복해서 써요. 그래서 같은 질문에도 토큰(글자 사용량)을 더 쓸 때가 있어요
- 비용이 더 중요하면 '생각하는 강도' 설정(노력 수준)을 낮추거나, 효율이 우선인 일은 3.7 플래시를 계속 쓰면 돼요. 3.7은 계속 지원됩니다
</aside>
4. 데모 영상 — 프롬프트 하나로 만든 것들
구글 안티그래비티(AI에게 코딩을 맡기는 개발 환경)와 구글 AI 스튜디오에서 프롬프트 한 줄씩으로 만든 결과물이에요. 영상은 구글 공식 발표문에 실린 원본입니다.